Criação de Sites no Japão

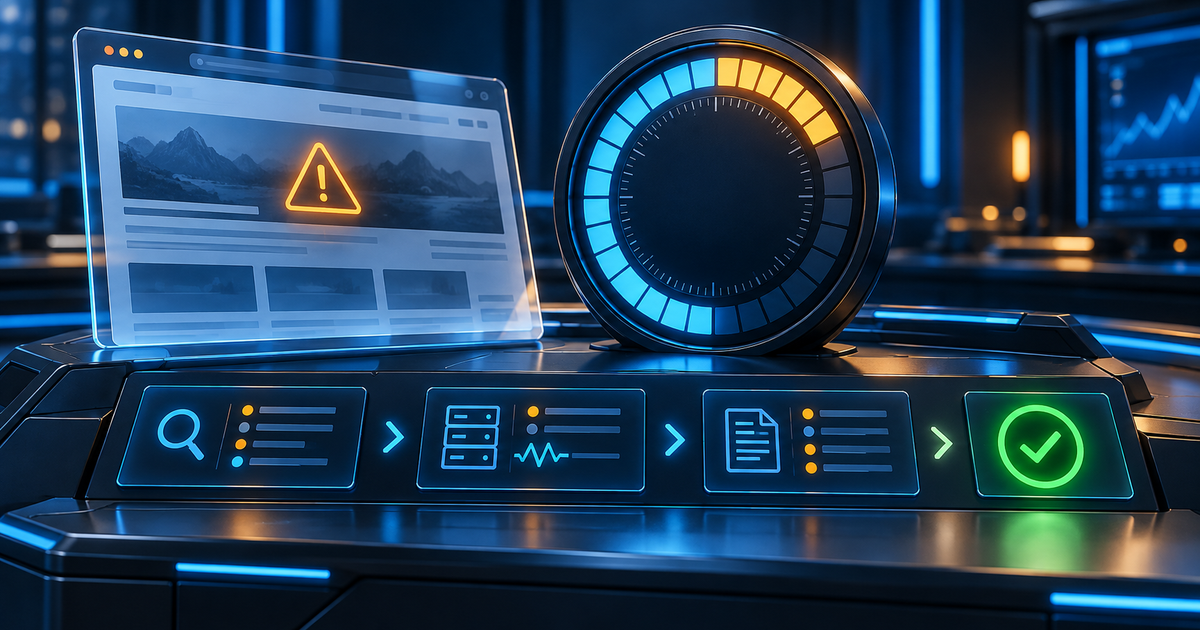
O cliente avisa que o site não abre. Outra pessoa manda uma captura de tela. Alguém sugere atualizar plugins, limpar tudo ou restaurar o último backup. Em poucos minutos, uma falha ainda mal compreendida pode ganhar várias mudanças simultâneas — e ninguém sabe mais o que aconteceu primeiro.
Quando o site sai do ar, a primeira tarefa não é encontrar um botão que faça tudo voltar. É organizar uma resposta que reduza impacto sem destruir dados, evidências ou caminhos de recuperação. Os primeiros 30 minutos devem produzir clareza: o que falhou, quem decide, qual ação é segura e como o negócio continuará atendendo.
Este roteiro é uma referência de coordenação para responsáveis por sites WordPress. Os intervalos ajudam a priorizar; não prometem recuperação em meia hora nem substituem uma pessoa técnica autorizada.
Uma tela de erro em um computador não confirma que toda a operação caiu. Verifique a página afetada em uma segunda conexão, como a rede móvel, e compare com uma página pública simples. Faça poucas consultas, sem testes de carga e sem repetir envios de formulário ou pagamentos.
Registre o horário com fuso, a URL, a mensagem exibida e o último momento conhecido de funcionamento. Uma captura ajuda, desde que não exponha dados pessoais, informações de pedidos ou credenciais.
Separe indisponibilidade total de falha parcial. Se a home abre, mas o envio de orçamento não funciona, o impacto comercial continua real. Por outro lado, um problema restrito à conexão de um visitante não justifica mudanças no servidor.
Descreva o sintoma observado, não uma causa presumida. “O formulário apresenta erro em duas conexões desde 10h15 JST” é mais útil que “o WordPress quebrou”. Essa diferença evita que a investigação comece com uma solução escolhida antes do diagnóstico.
Defina uma pessoa para coordenar o incidente, uma para a investigação técnica e uma para comunicar o andamento. Em um negócio pequeno, a mesma pessoa pode acumular funções, mas os papéis precisam estar claros.
O coordenador mantém a linha do tempo e aprova o escopo da intervenção. O responsável técnico verifica evidências e executa ações autorizadas. A comunicação informa apenas fatos confirmados, sem prometer prazo de recuperação ainda desconhecido.
Enquanto isso, suspenda atualizações, mudanças de DNS, edição de código e outras intervenções que não estejam ligadas a uma hipótese documentada. Peça que qualquer mudança já iniciada seja informada. Duas pessoas tentando “ajudar” em paralelo podem apagar a relação entre causa e efeito.
Consulte o histórico recente: implantação, atualização, alteração de configuração, vencimento de domínio, mudança de certificado ou aviso de limite de recursos. Proximidade no tempo é uma pista, não uma prova. A mudança mais recente não deve ser revertida automaticamente só por ser recente.
Quando houver relação com uma atualização, o processo de teste antes de mudanças em produção oferece contexto para investigar diferenças entre ambientes e localizar o componente afetado.
Uma falha pode estar no domínio, na resolução DNS, no certificado, na hospedagem, no WordPress ou em um serviço externo. A tela apresentada ao visitante nem sempre identifica essa camada com precisão.
A equipe técnica deve combinar o sintoma com os registros disponíveis. Um código de resposta isolado não comprova invasão, problema em plugin ou necessidade de restaurar o banco. Também não vale contornar alertas do navegador para concluir que o site está saudável.
A documentação de troubleshooting do WordPress distingue problemas como falha após atualização, indisponibilidade de manutenção e erro de conexão com banco. Use a referência correspondente ao caso, não uma lista de comandos aplicada indiscriminadamente.
Se o problema for lentidão grave, em vez de indisponibilidade, a abordagem para localizar o gargalo do site ajuda a separar comportamento da página, servidor e integrações. Instalar mais uma ferramenta durante o incidente pode introduzir outra variável sem resolver a origem.
Antes de reiniciar serviços, substituir arquivos ou restaurar dados, preserve os registros relevantes quando isso for possível e seguro. Anote mensagens, horários, mudanças recentes e identificadores de erro. Logs devem ficar em armazenamento protegido; nunca copie tokens, senhas ou dados de clientes para uma conversa pública.
Na suspeita de comprometimento — conteúdo alterado sem autorização, redirecionamento estranho ou conta desconhecida — acione o responsável por segurança. Contenção pode exigir ação imediata, mas deve considerar a preservação das evidências e o impacto. Não trate possível invasão como uma atualização comum.
Uma restauração também precisa de decisão consciente. Qual cópia será usada? Quais pedidos, contatos ou alterações posteriores poderiam desaparecer? Existe um procedimento testado e autorização para executá-lo? O conteúdo sobre recuperação verificável a partir de backup aprofunda essas dependências; ter um arquivo disponível não torna qualquer restauração segura.
Para cada intervenção, registre uma hipótese, a mudança exata, o resultado esperado e o caminho de reversão. Execute apenas o que a pessoa responsável domina e está autorizada a fazer. Se o ambiente não permite uma ação segura, escalar é melhor que improvisar.
Se uma ação não produz o resultado esperado, registre isso antes de tentar a seguinte. O objetivo não é colecionar tentativas, mas eliminar hipóteses sem ampliar a perda.
Quando depender da hospedagem ou de uma integração, envie um relato curto e reproduzível. Inclua domínio ou serviço afetado, horário com fuso, páginas atingidas, erro observado, extensão do impacto e mudanças recentes conhecidas.
Informe o que já foi verificado e pergunte qual camada apresenta falha, quais evidências sustentam essa conclusão e que ação o fornecedor pretende realizar. Se houver possibilidade de restaurar dados, deixe explícito que o impacto sobre registros recentes precisa ser avaliado antes.
Evite compartilhar uma senha administrativa por mensagem. Use o mecanismo seguro de acesso autorizado. O número do chamado e as respostas relevantes devem entrar na linha do tempo para que outra pessoa consiga assumir a coordenação.
Não espere resolver tudo para orientar quem depende do serviço. Uma mensagem útil informa a função afetada, a alternativa disponível e o horário da próxima atualização. Não precisa revelar detalhes técnicos sensíveis nem anunciar uma causa ainda incerta.
Por exemplo: “Estamos verificando uma falha no formulário de orçamento. Você pode entrar em contato pelo canal alternativo informado em nosso perfil oficial. Publicaremos uma nova atualização às 11h JST.” Esse é um modelo a adaptar, não um prazo real de recuperação.
O canal alternativo deve ser conhecido e, quando necessário, independente do domínio afetado. Se o e-mail usa a mesma infraestrutura indisponível, ele talvez não sirva como contingência. Confirme a capacidade de receber demandas antes de direcionar clientes.
Quando o site voltar, teste as funções que falharam, não só a página inicial. Valide páginas essenciais, login autorizado e fluxo de contato. Em operações transacionais, use testes controlados que não gerem cobranças, pedidos ou notificações duplicadas.
Serviço recuperado exige evidência funcional. A equipe deve confirmar também se há mensagens represadas, integrações interrompidas ou registros que precisam de reconciliação. O fim da tela de erro pode ser apenas o começo da recuperação operacional.
Aos 30 minutos, o importante é saber qual função continua afetada, quem conduz a próxima ação e quando haverá nova informação. Não execute uma restauração apressada apenas para cumprir o intervalo deste roteiro.
Registre a hipótese principal e as alternativas descartadas, o chamado aberto, o risco de perda de dados e a contingência em uso. Defina uma nova janela de atualização proporcional ao impacto. Se o incidente mudou de natureza, como de indisponibilidade para suspeita de comprometimento, atualize o responsável e o plano.
Depois da estabilização, revise a linha do tempo sem buscar culpados. Localize o primeiro ponto em que faltaram acesso, evidência, aprovação ou documentação. Essa informação deve virar melhoria no procedimento, não ficar esquecida em um grupo de mensagens.
Os primeiros 30 minutos de um site fora do ar devem reduzir incerteza e proteger a operação. Confirmar impacto, organizar responsáveis, preservar evidências, testar hipóteses e comunicar o estado é mais confiável que mudar vários componentes por impulso.
A rapidez que importa é a capacidade de decidir com segurança. Um roteiro simples, acessos preparados e critérios de validação ajudam a recuperar o serviço sem transformar uma falha limitada em um problema maior.
Não automaticamente. Confirme a natureza da falha, a integridade da cópia e o impacto sobre dados recentes. A restauração precisa de responsável, autorização, procedimento e validação.
Não como resposta universal. O problema pode estar em outra camada, e a desativação altera o funcionamento do site. Uma pessoa técnica deve avaliar evidências, dependências e reversibilidade antes de intervir.
Não. Confirme as funções afetadas e os fluxos críticos, incluindo integrações e registros pendentes. A recuperação deve ser verificada na operação real, com testes seguros.
Este roteiro não estabelece uma garantia. O prazo de recuperação depende da falha e das dependências. A primeira meia hora organiza resposta, proteção de dados e comunicação.
Escolha uma função crítica do seu site e registre quem coordena, quem pode intervir, qual canal alternativo existe e como confirmar a recuperação. Se você precisa estruturar esse processo para seu WordPress, a Dekassegui Digital pode ajudar a mapear dependências e organizar a manutenção com critérios claros de continuidade.
Muitos sites parecem bonitos, mas não geram clientes.
Solicite um Diagnóstico Gratuito da sua Presença Digital e descubra, em até 24 horas, o que está impedindo seu negócio de crescer online.
Receba gratuitamente novos artigos, insights estratégicos e tendências sobre:
📩 Assine gratuitamente.

Sites rápidos, modernos e preparados para conversão.
Descubra quanto custa desenvolver o site ideal para o seu negócio ou projeto no Japão.
Ajuste funcionalidades, páginas, idiomas e receba uma estimativa instantânea em ienes.


Muitos sites parecem bonitos, mas não geram clientes.
Solicite um Diagnóstico Gratuito da sua Presença Digital e descubra, em até 24 horas, o que está impedindo seu negócio de crescer online.
Receba gratuitamente novos artigos, insights estratégicos e tendências sobre:
📩 Assine gratuitamente.